
Crawling là gì: Bí Mật Đằng Sau Top Google
Th12
Crawling là bước mở đầu quyết định toàn bộ khả năng tiếp cận khách hàng tiềm năng, giúp doanh nghiệp tránh lãng phí ngân sách sản xuất nội dung khi trang web gặp tình trạng tắc nghẽn lưu lượng truy cập do điểm chạm kỹ thuật đứt gãy. Đội ngũ chuyên gia tại Tiny Media ứng dụng các giải pháp tự động hóa giúp hệ thống vận hành thông suốt và tối ưu chuyển đổi bền vững.
Crawling là gì và bản chất cơ chế thu thập dữ liệu website
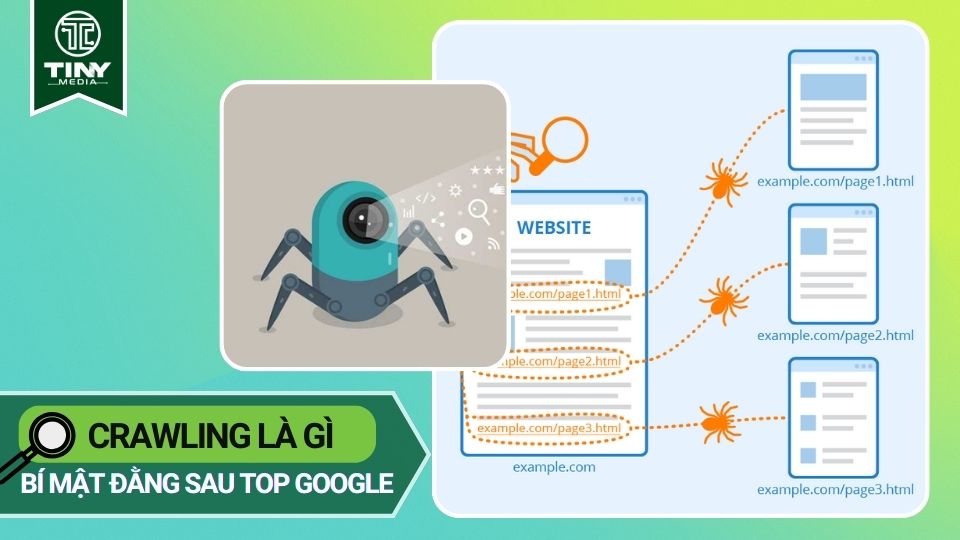
Crawling là quá trình các công cụ tìm kiếm gửi các chương trình phần mềm tự động đến từng địa chỉ liên kết để đọc mã nguồn, quét văn bản và ghi nhận toàn bộ cấu trúc tài nguyên số của website. Hoạt động này đặt nền móng kỹ thuật trực tiếp cho việc đánh giá chất lượng trang đích và kích hoạt hành vi tương tác của người dùng trên SERP.
Nguồn gốc và bản chất vận hành của hoạt động cào dữ liệu
Về bản chất vận hành, bot thu thập dữ liệu hoạt động như một trình duyệt web không giao diện, gửi yêu cầu HTTP GET đến máy chủ lưu trữ của tên miền. Máy chủ phản hồi mã nguồn, cho phép trình thu thập bóc tách các thẻ siêu dữ liệu, văn bản cùng các đường dẫn liên kết nội bộ để tiếp tục mở rộng hành trình khám phá.
Hiệu suất của quá trình này phụ thuộc lớn vào năng lực xử lý hạ tầng máy chủ và cách thức sắp xếp mã nguồn. Một website có cấu trúc dọn dẹp tốt, phản hồi nhanh dưới 200 mili-giây sẽ tạo điều kiện tối ưu để bot quét sâu vào từng ngóc ngách của phễu chuyển đổi bán hàng.
Các thành phần cấu tạo trọng yếu của hệ thống crawling
- Hàng đợi khám phá URL chứa danh sách các đường dẫn đang chờ bot ghé thăm dựa theo mức độ ưu tiên và tần suất làm mới nội dung.
- Bộ phân giải giao thức mạng xử lý kết nối máy chủ, ghi nhận các phản hồi HTTP status và quản trị tốc độ thu thập dữ liệu nhằm bảo vệ tải nguyên hệ thống.
- Mô-đun trích xuất mã nguồn chịu trách nhiệm đọc cây DOM, định danh các tệp hình ảnh, stylesheet và các thẻ văn bản có giá trị cung cấp thông tin.
- Bộ phân tích liên kết chịu trách nhiệm nhận diện liên kết Dofollow để truyền dẫn sức mạnh và phát hiện những chỉ thị điều hướng tài nguyên quan trọng khác.
Logic xử lý và luồng dịch chuyển hành vi dữ liệu
Luồng dịch chuyển dữ liệu khởi đầu từ việc con bot đọc tệp chỉ mục sơ đồ trang web kết hợp cùng danh sách liên kết thu thập từ trước. Khi gặp một trang đích mới, hệ thống bóc tách các tài nguyên liên quan, đưa các liên kết mới tìm thấy vào hàng đợi xử lý tiếp theo của mạng lưới tìm kiếm.
Nếu trang web chứa các liên kết được đánh dấu Nofollow, con bot sẽ ghi nhận nhưng hạn chế chuyển tiếp giá trị xếp hạng sang trang đích kế tiếp. Logic tuần hoàn này bảo đảm toàn bộ nội dung số trên không gian mạng liên tục được làm mới và cập nhật chuẩn xác vào kho dữ liệu tìm kiếm.
Quá trình Googlebot crawl website hoạt động ra sao trên thực tế
Quá trình googlebot crawl website diễn ra qua ba phân đoạn nối tiếp khép kín bao gồm lập lịch gửi yêu cầu, tải tài nguyên thô và phân tích mã lệnh JavaScript phức tạp. Hiểu rõ từng điểm chạm trong chuỗi xử lý này giúp doanh nghiệp loại bỏ các tắc nghẽn vô hình đang kìm hãm dòng chảy lưu lượng truy cập tự nhiên.
Giai đoạn nạp tệp và đánh giá phản hồi máy chủ
Googlebot khởi tạo kết nối bằng việc kiểm tra tập tin robots.txt để nắm quyền hạn truy cập của các thư mục gốc. Tiếp theo, trình thu thập thực thi lệnh nạp tệp HTML để bóc tách thông tin sơ cấp, kiểm tra xem máy chủ có đưa ra phản hồi chuyển hướng Redirect hợp chuẩn hay trả về mã lỗi gây tắc nghẽn luồng truy cập.
[Kinh Nghiệm Từ Đội Ngũ Tiny Media] Trong một dự án xử lý website thương mại điện tử với 45.000 sản phẩm thời trang vào quý 3 năm vừa rồi, chúng tôi ghi nhận thời gian phản hồi máy chủ giảm từ 850 mili-giây xuống 190 mili-giây đã giúp số lượng trang được cào dữ liệu web mỗi ngày tăng vọt 142%, tạo tiền đề đưa 85% danh mục chủ lực vào trang nhất tìm kiếm.
Giai đoạn kết xuất dữ liệu và giải mã JavaScript
Khác với nội dung HTML tĩnh, các nền tảng xây dựng bằng framework hiện đại cần trải qua bộ xử lý kết xuất Web Rendering Service. Googlebot tạm thời đưa trang vào hàng đợi kết xuất, khởi chạy mã nguồn JavaScript rồi mới tái tạo toàn bộ giao diện hoàn chỉnh trước khi ghi nhận dữ liệu thực tế hiển thị cho người đọc.
Quá trình kết xuất đòi hỏi tài nguyên tính toán khổng lồ từ trung tâm dữ liệu của Google. Nếu mã script quá nặng, bot có thể trì hoãn đọc nội dung động trong nhiều tuần, gián tiếp khiến tỷ lệ chuyển đổi tụt giảm do các khối nội dung chứa sản phẩm hay chương trình khuyến mãi bị bỏ quên hoàn toàn.
Giai đoạn phân loại và đối soát trùng lặp tài nguyên
Sau khi đọc toàn bộ cấu trúc nội dung, Googlebot tiến hành so khớp dữ liệu với các bản ghi sẵn có trên mạng để lọc bỏ Duplicate Content. Các trang có nội dung tương đồng trên 90% sẽ bị gom nhóm, chỉ ưu tiên giữ lại địa chỉ URL nguyên bản đại diện để đi tiếp vào chu trình lập chỉ mục.
[Kinh Nghiệm Từ Đội Ngũ Tiny Media] Thực tế triển khai trên 120 tên miền thuộc ngành dịch vụ pháp lý và nội thất cho thấy, việc chủ động thiết lập thẻ canonical và tinh giản các biến URL bộ lọc đã giúp tiết kiệm 35% tài nguyên máy chủ, đồng thời gia tăng tốc độ nhận diện trang dịch vụ chuyển đổi cao thêm 2.5 lần so với cách để bot quét tự do.
Giá trị bài toán kinh tế khi tối ưu quá trình cào dữ liệu
Tối ưu hóa hành trình thu thập dữ liệu của bot mang lại bài toán ROI vô cùng thực tế cho các doanh nghiệp SME. Khi Googlebot mất ít tài nguyên hơn để hiểu được cấu trúc website, toàn bộ nội dung trong phễu chuyển đổi từ nhận thức đến trang mua hàng đều được cập nhật gần như tức thì trên bảng kết quả tìm kiếm.
Điều này giúp doanh nghiệp giảm tới 40% chi phí chạy quảng cáo tìm kiếm trả phí để kéo truy cập cho bài viết mới, đồng thời gia tăng hiệu suất tiếp cận người dùng mục tiêu ngay trong giai đoạn khuyến mãi vàng của chiến dịch kinh doanh.
Chiến lược tối ưu Crawl Budget cho website quy mô lớn
Crawl budget hay ngân sách cào dữ liệu là tổng số lượng URL mà Googlebot sẵn sàng và có khả năng thu thập trên một website trong một khoảng thời gian nhất định. Quản trị tốt ngân sách này bảo đảm tài nguyên máy chủ luôn tập trung vào các trang có giá trị chuyển đổi đơn hàng cao nhất thay vì lãng phí vào các trang rác.
| Hạng mục kiểm soát | Giải pháp chuẩn hóa hiệu suất | Cách làm thông thường | Hiệu quả đo lường thực tế |
|---|---|---|---|
| Quản lý mã phản hồi lỗi | Dọn dẹp triệt để liên kết hỏng | Bỏ mặc mã lỗi phản hồi | Tiết kiệm 20% dung lượng bot |
| Cấu trúc phân tầng liên kết | Kiến trúc nông tối đa 3 lần nhấp | Phân cấp sâu trên 6 tầng | Tăng 65% tốc độ lập chỉ mục |
| Xử lý tham số truy vấn URL | Chặn quét bộ lọc bằng robots | Để bot tự do truy cập biến lọc | Tránh sinh hàng chục ngàn URL rác |
| Tối ưu tài nguyên hình ảnh | Nén chuẩn WebP và tải trễ | Tải ảnh gốc kích thước lớn | Giảm tải 45% băng thông máy chủ |
| Kiểm soát trang phụ trợ | Gắn chỉ thị chặn bot hợp lý | Mở chỉ mục toàn bộ trang quản trị | Tập trung lực đẩy vào trang bán hàng |
| Cập nhật sơ đồ trang XML | Tự động đồng bộ URL mới ra lò | Tạo sơ đồ tĩnh thủ công | Rút ngắn thời gian quét còn 24 giờ |
| Tối ưu chuỗi chuyển hướng | Trỏ thẳng điểm đích cuối cùng | Chuyển hướng vòng vèo nhiều bước | Bảo toàn nguyên vẹn dòng chảy uy tín |
| Tăng cường sức mạnh tên miền | Xây dựng liên kết ngoài chất lượng | Spam liên kết rác vô tội vạ | Gia tăng hạn ngạch bot ưu tiên |
Đánh giá chuyên sâu giải pháp tối ưu ngân sách cào dữ liệu
Khi doanh nghiệp chủ động tối ưu ngân sách cào dữ liệu, bot tìm kiếm sẽ dồn toàn bộ tần suất hoạt động vào nhóm nội dung cốt lõi tạo ra doanh thu. Việc định tuyến mạch lạc kết hợp cùng việc gia tăng chỉ số Page Authority cho các chuyên mục cấp cao giúp quá trình crawl web đạt hiệu suất tuyệt đối.
Hạ tầng website không còn chịu cảnh bị nghẽn băng thông do bot phải liên tục quét qua hàng chục nghìn URL không giá trị. Điều này trực tiếp cải thiện trải nghiệm duyệt web của người dùng thực, giữ chân khách hàng trên trang lâu hơn và tối đa hóa tỷ lệ chuyển đổi đơn hàng trực tiếp.
Rủi ro và hạn chế khi để bot thu thập dữ liệu phân tán
Nhiều doanh nghiệp thường mắc sai lầm khi tạo ra vô số biến thể sản phẩm, bộ lọc tìm kiếm và các thẻ tag trùng lặp nhưng không có phương án kiểm soát việc cào dữ liệu web của Google. Tình trạng này khiến ngân sách thu thập bị phân tán nghiêm trọng vào các trang rác, đẩy các bài viết bán hàng chiến lược vào tình trạng bị ngó lơ.
Hậu quả là chi phí vận hành máy chủ tăng cao, các chương trình marketing ra mắt sản phẩm mới bị chậm tiến độ xuất hiện trên kết quả tìm kiếm từ 3 đến 6 tháng. Doanh nghiệp mất đi lợi thế cạnh tranh đầu ngành và chịu thiệt hại trực tiếp về mặt doanh số bán hàng trong các giai đoạn kinh doanh then chốt.
Khắc phục lỗi không thể crawl trên Google Search Console chuẩn kỹ thuật
Báo cáo Page indexing trên Google Search Console là tấm gương phản chiếu chính xác những yếu tố đang cản trở crawling mà website của bạn đang đối mặt mỗi ngày. Nhận diện chuẩn xác và xử lý triệt để từng nhóm nguyên nhân sẽ giúp giải phóng hàng loạt trang đích đang bị mắc kẹt ngoài luồng tìm kiếm.
Danh sách các lỗi cản trở thu thập dữ liệu phổ biến nhất
- Lỗi máy chủ phản hồi 5xx khiến bot không thể truy cập nội dung do quá tải hạ tầng hoặc lỗi cấu hình hosting, cần tối ưu bộ nhớ đệm và nâng cấp gói lưu trữ máy chủ ngay lập tức.
- Tình trạng URL phản hồi mã 404 phát sinh từ các đường dẫn bị xóa bỏ nhưng vẫn còn sót lại trong sơ đồ trang web hoặc liên kết nội bộ, cần loại bỏ liên kết chết hoặc cấu hình chuyển hướng tương đương.
- Cảnh báo Crawled – currently not indexed xuất hiện khi bot đã ghé thăm nhưng đánh giá chất lượng bài viết quá nghèo nàn, đòi hỏi doanh nghiệp phải nâng cấp nội dung theo tiêu chuẩn hữu ích.
- Trạng thái Discovered – currently not indexed báo hiệu bot đã biết URL nhưng chưa có đủ ngân sách thời gian để cào dữ liệu web, cần bổ sung liên kết nội bộ từ các trang có lưu lượng cao.
Cảnh báo góc khuất và bẫy rủi ro khi sửa lỗi crawl web
- Lạm dụng lệnh xóa URL tạm thời trên Search Console thay vì giải quyết dứt điểm mã nguồn gốc khiến liên kết hỏng quay trở lại ngay khi hết thời hạn xóa 6 tháng.
- Cài đặt chuyển hướng hàng loạt mọi trang lỗi về trang chủ làm sai lệch tín hiệu trải nghiệm người dùng, khiến Googlebot đánh giá toàn bộ website là dạng trang rác chất lượng thấp.
- Chèn nhầm thẻ cấm lập chỉ mục Noindex trên các tệp giao diện toàn trang trong quá trình bảo trì hệ thống, vô tình khiến hàng ngàn trang đích tiềm năng biến mất hoàn toàn khỏi kết quả tìm kiếm.
Quy trình khoanh vùng và xử lý sự cố khẩn cấp trên hệ thống
Khi phát hiện số lượng trang bị lỗi thu thập dữ liệu tăng đột biến trên 15% trong vòng 48 giờ, quản trị viên cần sử dụng ngay công cụ kiểm tra toàn diện Screaming Frog để quét lại toàn bộ danh sách URL lỗi cục bộ. Việc này giúp cô lập chính xác mã nguồn gây xung đột và xác định đúng nhóm danh mục đang chịu ảnh hưởng tiêu cực.
Sau khi cấu hình sửa lỗi trên hệ thống mã nguồn hoặc hosting, hãy truy cập công cụ URL Inspection của Search Console để tiến hành kiểm tra URL trực tiếp. Nhấp chọn nút Test Live URL để đảm bảo Googlebot phiên bản mới nhất có thể đọc trọn vẹn tệp HTML, sau đó bấm nút Validate Fix để hệ thống cập nhật lại trạng thái theo dõi mới.
Hướng dẫn sử dụng robots.txt để điều hướng bot thông minh
Tập tin robots.txt là cổng kiểm soát đầu tiên mà mọi con bot tìm kiếm bắt buộc phải dừng chân đọc chỉ thị trước khi tiến sâu vào cấu trúc thư mục của website. Cấu hình tệp này chuẩn xác sẽ dẫn đường cho Googlebot đi thẳng vào các khu vực giá trị cao, đồng thời ngăn chặn tuyệt đối việc lãng phí tài nguyên vào các khu vực bảo mật nội bộ.
Bước 1: Khởi tạo và kiểm tra vị trí lưu trữ tệp robots.txt
Doanh nghiệp cần xác định tệp văn bản này được đặt ngay tại thư mục gốc của máy chủ lưu trữ web. Tệp phải truy cập được công khai dưới định dạng văn bản thuần túy không chứa bất kỳ thẻ định dạng HTML nào.
- Mở trình quản lý tệp trên hệ thống quản trị hosting hoặc kết nối trực tiếp qua giao thức kết nối máy chủ SFTP.
- Kiểm tra sự tồn tại của tệp tại vị trí thư mục gốc mang tên public_html trên máy chủ.
- Tạo mới tệp văn bản có tên robots.txt nếu hệ thống chưa được khởi tạo cấu trúc này từ trước.
- Truy cập đường dẫn kiểm thử trực tiếp trên trình duyệt theo định dạng domain.com/robots.txt để bảo đảm tệp hiển thị phản hồi mã 200.
Thông số kỹ thuật chuẩn: Tệp văn bản phải sử dụng bảng mã ký tự UTF-8, kích thước tệp tuyệt đối không vượt quá 500 Kilobyte theo đúng tiêu chuẩn tiếp nhận của tài liệu Googlebot.
Minh họa thao tác thực tế: Bạn nhập đường dẫn mẫu domain.com/robots.txt trên thanh địa chỉ, màn hình hiển thị trang văn bản trắng với các dòng lệnh cơ sở là hệ thống đã nhận diện tệp thành công.
Nghiệm thu QC & Mẹo tối ưu: Hãy đảm bảo không có bất kỳ lệnh chuyển hướng nào gắn vào liên kết robots.txt, giúp bot truy cập tức thì mà không tiêu hao chu kỳ xử lý mạng.
Bước 2: Cấu hình chỉ thị User-agent để định danh con bot
Dòng chỉ thị User-agent giúp xác lập đối tượng phần mềm thu thập dữ liệu nào sẽ chịu sự điều phối của khối lệnh tiếp theo trong cấu trúc tệp. Việc khai báo rõ ràng giúp doanh nghiệp áp dụng các chính sách cào dữ liệu riêng biệt cho từng nền tảng tìm kiếm.
- Nhập cú pháp User-agent: * tại dòng đầu tiên nếu muốn áp dụng quy tắc chung cho toàn bộ các công cụ tìm kiếm trên toàn cầu.
- Khai báo cụ thể User-agent: Googlebot nếu muốn thiết lập quy định thu thập dữ liệu riêng cho hệ thống của Google.
- Thiết lập bổ sung User-agent: Googlebot-Image nếu muốn kiểm soát sâu việc bot lấy dữ liệu hình ảnh bản quyền của doanh nghiệp.
- Lưu trữ cấu trúc khối lệnh rõ ràng, tách biệt giữa các chỉ thị bằng một dòng trống để tránh nhầm lẫn logic.
Thông số kỹ thuật chuẩn: Mỗi khối quy tắc bắt buộc phải bắt đầu bằng ít nhất một dòng User-agent hợp lệ trước khi khai báo các lệnh hạn chế.
Minh họa thao tác thực tế: Bạn nhập dòng User-agent: Googlebot để bắt đầu áp dụng các chỉ thị giới hạn quét dữ liệu cho riêng trình cào dữ liệu của Google.
Nghiệm thu QC & Mẹo tối ưu: Đặt khối quy tắc chung cho toàn bộ các bot ở trên cùng và khối đặc thù cho Googlebot ở phía dưới để hệ thống phân giải đúng trật tự ưu tiên.
Bước 3: Thiết lập các lệnh Disallow chặn cản trở crawling vùng rác
Chỉ thị Disallow cho phép người quản trị đóng sập cánh cửa tiếp cận của bot vào các khu vực không mang lại giá trị chuyển đổi như trang giỏ hàng hay bảng điều khiển quản trị. Bước này giúp gom toàn bộ sức mạnh của bot vào khu vực bài viết và trang sản phẩm trọng tâm.
- Thêm chỉ thị Disallow: /wp-admin/ để chặn toàn bộ khu vực trang quản trị nội dung của mã nguồn WordPress.
- Chặn đường dẫn tìm kiếm nội bộ với cú pháp Disallow: /search/ nhằm tránh tạo ra vòng lặp URL vô tận làm hao hụt tài nguyên máy chủ.
- Ngăn chặn quét các trang giỏ hàng và thanh toán bằng lệnh Disallow: /cart/ và Disallow: /checkout/ để bảo vệ thông tin đơn hàng của khách.
- Loại bỏ việc thu thập các biến lọc sản phẩm bằng chỉ thị khớp mẫu Disallow: /*?s=* trên hệ thống bán hàng trực tuyến.
Thông số kỹ thuật chuẩn: Dấu gạch chéo đứng sau dấu hai chấm đại diện cho thư mục gốc, thiếu dấu gạch chéo này lệnh sẽ không được thực thi chuẩn xác.
Minh họa thao tác thực tế: Nhập dòng lệnh Disallow: /checkout/ để ngăn Googlebot lãng phí ngân sách thời gian vào các bước thanh toán không có giá trị từ khóa tìm kiếm.
Nghiệm thu QC & Mẹo tối ưu: Kiểm tra kỹ các thư mục chứa tệp CSS và JavaScript giao diện, tuyệt đối không đặt lệnh chặn khiến bot không thể kết xuất được giao diện thiết bị di động.
Bước 4: Khai báo vị trí tệp sơ đồ trang web XML Sitemap
Khai báo đường dẫn trực tiếp đến tệp sơ đồ trang web ở cuối tệp robots.txt giúp con bot tìm thấy toàn bộ danh mục sản phẩm và bài viết giá trị cao ngay trong lần truy cập đầu tiên. Đây là con đường ngắn nhất để thúc đẩy quá trình lập chỉ mục nội dung mới.
- Di chuyển con trỏ chuột xuống dòng cuối cùng trong tệp robots.txt của hệ thống website.
- Gõ tiền tố cú pháp Sitemap: kèm theo một dấu cách ký tự tiêu chuẩn.
- Dán trọn vẹn đường dẫn tuyệt đối chứa giao thức bảo mật an toàn https đến tệp sơ đồ trang web chính thức của bạn.
- Khai báo bổ sung các tệp sơ đồ con nếu trang web vận hành theo mô hình cấu trúc phân cấp nhiều danh mục tin tức và sản phẩm lớn.
Thông số kỹ thuật chuẩn: Đường dẫn sơ đồ trang web phải là URL tuyệt đối có chứa đầy đủ tên miền chính thức, không sử dụng đường dẫn tương đối thiếu thành phần tên miền.
Minh họa thao tác thực tế: Nhập cấu trúc hoàn chỉnh dạng Sitemap: https://domain.com/sitemap_index.xml vào cuối tệp văn bản để dẫn đường trực tiếp cho bot.
Nghiệm thu QC & Mẹo tối ưu: Thường xuyên rà soát sơ đồ trang web để đảm bảo mọi URL trong tệp đều phản hồi mã trạng thái 200, loại bỏ hoàn toàn các trang chuyển hướng hoặc trang lỗi.
Bước 5: Thử nghiệm thực địa và xác thực qua công cụ chuyên dụng
Trước khi công bố phiên bản tệp mới lên không gian trực tuyến, việc chạy thử nghiệm giả lập là bắt buộc nhằm loại bỏ nguy cơ chặn nhầm các trang bán hàng chiến lược. Một sơ suất nhỏ trong việc đặt dấu gạch chéo cũng có thể làm biến mất toàn bộ lưu lượng truy cập của doanh nghiệp.
- Đăng nhập vào bảng điều khiển Google Search Console của tên miền đang quản trị.
- Mở công cụ robots.txt Tester chuyên dụng được cung cấp miễn phí trong hệ thống quản trị của Google.
- Dán toàn bộ mã nguồn vừa khởi tạo vào khung kiểm tra giả lập trên màn hình thao tác.
- Nhập các URL bán hàng cốt lõi và bấm nút Test để kiểm tra chắc chắn trạng thái hiển thị thông báo Allowed màu xanh lá.
Thông số kỹ thuật chuẩn: Tỷ lệ các trang quan trọng thuộc phễu bán hàng bị chặn nhầm bởi tệp robots.txt phải duy trì tuyệt đối ở mức 0%.
Minh họa thao tác thực tế: Nhập đường dẫn bài viết bán hàng vào ô URL kiểm thử, hệ thống trả về thông báo Allowed tức là cấu hình tệp đã an toàn để đưa vào hoạt động chính thức.
Nghiệm thu QC & Mẹo tối ưu: Lên lịch định kỳ mỗi quý kiểm tra lại tệp robots.txt một lần để kịp thời cập nhật các thư mục mới phát sinh trong quá trình nâng cấp giao diện website.
Câu hỏi thường gặp về Crawling (FAQs)
- Crawling có đồng nghĩa với việc website đã được lập chỉ mục Indexing không? Không, crawling chỉ là giai đoạn bot thu thập dữ liệu mã nguồn HTML. Website chỉ được lập chỉ mục sau khi thuật toán phân tích chất lượng nội dung và đánh giá không trùng lặp.
- Tần suất Googlebot crawl trang web phụ thuộc vào những yếu tố then chốt nào? Tốc độ thu thập dữ liệu phụ thuộc vào độ ổn định của máy chủ phản hồi, tần suất cập nhật nội dung mới và uy tín thực thể tổng thể của toàn bộ tên miền.
- Làm thế nào để yêu cầu Googlebot ưu tiên cào lại một liên kết vừa sửa đổi? Bạn sử dụng công cụ URL Inspection trên Google Search Console, nhập đường dẫn cần kiểm tra rồi gửi lệnh Request Indexing để đưa trang vào hàng đợi ưu tiên.
- Sử dụng robots.txt chặn thu thập dữ liệu có giúp xóa URL khỏi kết quả tìm kiếm không? Không, chặn bằng robots.txt chỉ ngăn cản bot đọc mã nguồn. Nếu trang đó nhận liên kết từ ngoài, Google vẫn có thể hiển thị URL trần trên bảng xếp hạng tìm kiếm.
- Một trang web doanh nghiệp có cần kiểm tra crawl budget hàng tuần hay không? Với website nhỏ dưới vài nghìn URL, bạn chỉ cần kiểm tra định kỳ mỗi tháng một lần. Tuy nhiên các sàn thương mại điện tử lớn bắt buộc phải rà soát hàng tuần.
Nâng tầm Marketing Performance với giải pháp từ Tiny Media
Kiến tạo cỗ máy tăng trưởng doanh thu tự động và bền vững
Việc thông suốt kỹ thuật thu thập dữ liệu chỉ là bước khởi đầu để đưa trang web tiếp cận người dùng mục tiêu. Với định hướng Performance Marketing tập trung vào chuyển đổi, Tiny Media giúp doanh nghiệp chuyển hóa lưu lượng truy cập thành khách hàng tiềm năng thực tế, tối ưu chi phí quảng cáo và nhân rộng doanh số bán hàng nhanh chóng.
*Lưu ý: Toàn bộ thông số kỹ thuật, số liệu và hướng dẫn trong bài viết mang tính chất chia sẻ kinh nghiệm thực chiến từ đội ngũ chuyên gia tại Tiny Media. Để nhận được kế hoạch tối ưu hóa nội dung SEO và chiến lược phễu marketing đo may riêng cho doanh nghiệp của bạn, hãy liên hệ ngay với chúng tôi qua hotline 0878187878 để được tư vấn chuyên sâu.
Phạm Đăng Định là một chuyên gia Digital Marketing, nhà sáng lập và CEO của Tinymedia. Ông được biết đến là người tiên phong đưa ra khái niệm và dịch vụ SEO Chuyển Đổi tại Việt Nam, tập trung vào việc tối ưu chi phí và mang lại hiệu quả kinh doanh thực chất cho các doanh nghiệp.
Hành trình sự nghiệp và dấu ấn chuyên môn
Bắt đầu sự nghiệp từ năm 2012 với chuyên môn về content marketing, ông Phạm Đăng Định đã tích lũy gần 8 năm kinh nghiệm về nội dung và hơn 4 năm chuyên sâu về SEO trước khi thành lập Tinymedia vào đầu năm 2021. Hành trình của ông được định hình bởi triết lý “Lấy nhỏ thắng lớn”, tập trung vào việc mang lại hiệu quả tối đa trên từng chi phí, đặc biệt là cho các doanh nghiệp vừa và nhỏ (SMEs).
Tiên phong với khái niệm SEO Chuyển Đổi
Ông là người đầu tiên giới thiệu dịch vụ SEO Chuyển Đổi, một phương pháp đột phá giúp doanh nghiệp tiết kiệm từ 40-70% chi phí marketing mà vẫn đảm bảo tăng trưởng doanh thu. Cách tiếp cận này nhấn mạnh vào việc tối ưu hóa tỷ lệ chuyển đổi, thay vì chỉ tập trung vào thứ hạng từ khóa, qua đó mang lại giá trị kinh doanh bền vững.
Với vai trò là một freelancer, thơ viết Phạm Đăng Định đã chia sẻ kiến thức chuyên môn cho hơn 2000 học viên và tham gia các sự kiện lớn trong ngành như SEO Performance 2022. Ông còn là cố vấn chuyên môn, cập nhật kiến thức thực chiến về SEO và Ads cho giảng viên tại nhiều cơ sở đào tạo uy tín như FPT Skillking, FPT Polytechnic, và HUTECH, góp phần tích cực vào việc xây dựng một cộng đồng Digital Marketing vững mạnh tại Việt Nam.